AI開発・実装
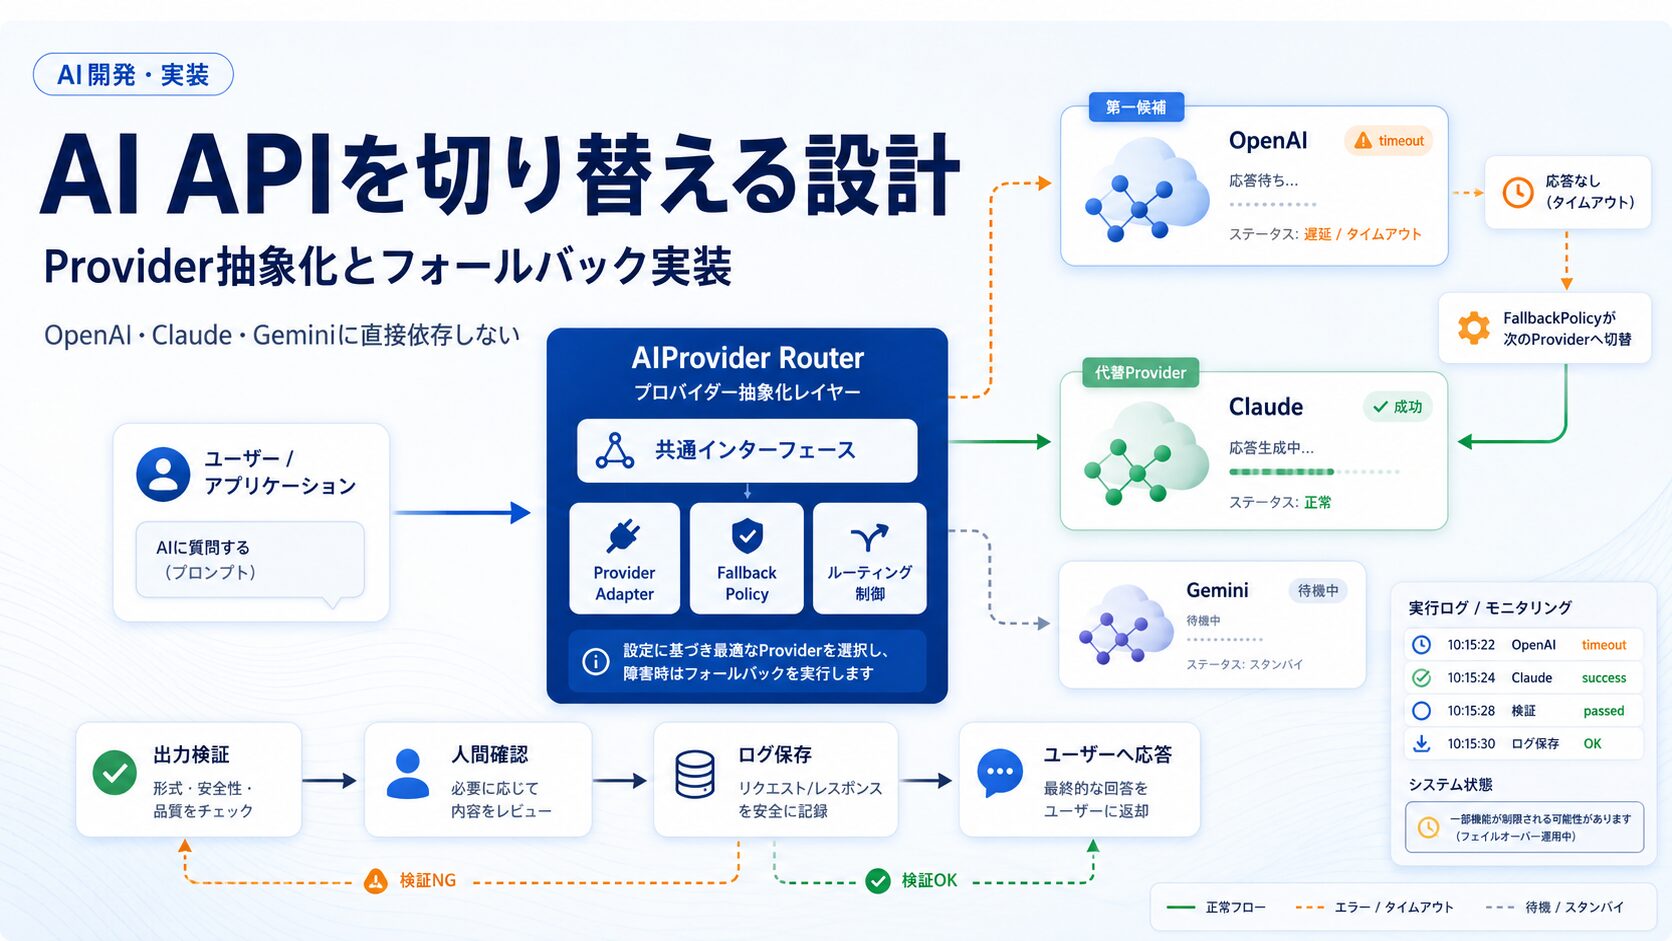
AI APIを使ったツールでは、特定ProviderのSDK呼び出しをControllerやUseCaseへ直接書かない方が安全です。
共通インターフェースの背後へProvider固有処理を閉じ込めることで、障害やモデル終了が起きたときも変更範囲を限定できます。
この記事では、OpenAI・Anthropic・GoogleのAI APIを切り替えられる最小構成と、フォールバックしてよいエラー、出力検証、ログ保存、縮退運転までをFastAPI・Pythonで整理します。
先に結論
重要なのは、別のAIへ切り替えられることだけではありません。
切り替える条件を明示し、切り替え後の出力を検証し、すべてのProviderが使えない場合は縮退運転や人間確認へ移れることが、実務で使えるAIツール設計です。
本記事のコード例は、テキスト生成だけに絞った最小構成です。Streaming、画像、音声、tool calling、複雑なAIエージェントは対象外としています。
各Providerのモデル名は変更されるため、コードへ固定せず環境変数で指定します。
先に結論:AI APIの呼び出しをアプリ全体へ直書きしない
AIツールを小さく試している段階では、FastAPIのルートやUseCaseからOpenAI SDKを直接呼び出しても動きます。
しかし、その呼び出しが複数箇所へ増えると、モデル終了やAPI障害が起きたときに、アプリ全体を修正しなければならなくなります。
避けたい構成
特定SDKを各処理から直接呼ぶ
- ControllerがOpenAI SDKを呼ぶ
- 別のUseCaseがAnthropic SDKを呼ぶ
- Provider固有レスポンスを画面やDBで使う
- 障害時の条件分岐が各所へ散らばる
推奨する構成
共通AIProviderの背後へ分離する
- UseCaseは共通AIProviderだけを見る
- SDK差は各Adapter内で吸収する
- 共通リクエスト・レスポンスを使う
- 切り替え条件をFallbackPolicyへ集約する
なぜ1社・1モデルへの依存が危険なのかは、 Claude Fable 5 / Mythos 5のアクセス停止から考えるモデル依存リスク で整理しています。
今回は、その問題に対して実装面からどう備えるかを具体化します。
Provider・モデル・フォールバック・縮退運転の違い
Providerを切り替えることと、同じProvider内でモデル名を変更することは同じではありません。
| 用語 | 意味 | 具体例 |
|---|---|---|
| Provider | AI APIを提供する会社・基盤 | OpenAI、Anthropic、Google |
| Model | Providerが提供する個別モデル | 各社の高性能モデル・軽量モデル |
| Provider抽象化 | 各社SDKの違いを共通インターフェースの背後へ隠す設計 | AIProviderをUseCaseから利用する |
| モデル切り替え | 同じProvider内で別モデルへ変更すること | 高性能モデルから軽量モデルへ変更 |
| フォールバック | 第一候補が失敗したとき、別モデル・別Providerを試すこと | Anthropic失敗後にOpenAIを試す |
| フェイルオーバー | 障害時に代替系統へ切り替え、サービス継続を目指す考え方 | 障害中のProviderを一時的に候補から外す |
| 縮退運転 | 全機能を維持できない場合に、機能を限定して継続すること | 生成を止め、保存済み構成と手動編集だけ提供 |
フォールバックは「別のAIを試すこと」です。
縮退運転は「AIが使えなくても、機能を限定してサービスを続けること」です。
特定Providerへ直接依存すると何が起きるか
修正範囲が広がる
SDK呼び出しが複数箇所へ散らばると、モデル終了や仕様変更のたびにController、UseCase、テスト、DB処理を修正することになります。
Provider固有型が漏れる
SDK固有のレスポンス型を上位層へ返すと、画面や保存形式までProviderに依存します。
障害時に切り替えにくい
どのエラーなら別Providerへ送るかが整理されていないと、場当たり的な条件分岐が増えます。
テストで本番APIを呼びやすい
FakeProviderへ差し替えられない構成では、テストのたびに外部API、料金、レート制限へ依存します。
コスト比較が難しい
使用量・遅延・採用結果を共通形式で残さないと、Providerごとの実務評価ができません。
独自機能に縛られる
Provider固有機能をアプリ全体で使うほど、別Providerへの移行コストは高くなります。
最小アーキテクチャ
個人開発で大規模な基盤を作る必要はありません。
最初は、責務が混ざらない最低限の構成で十分です。
FastAPIへの依存性注入では、ルート関数が必要とするUseCaseを宣言し、組み立て処理を別の場所へ置きます。
これにより、テスト時は実ProviderではなくFakeProviderへ差し替えられます。
AIツール全体の作り方から確認したい場合は、 AIツール個人開発の始め方 も先に確認してください。
共通リクエストと共通レスポンスを定義する
Provider抽象化では、各社SDKのリクエスト・レスポンスをそのまま上位層へ渡しません。
AIRequest
- system_instruction
- user_input
- temperature
- max_output_tokens
- response_format
- metadata
AIResponse
- content
- provider
- model
- finish_reason
- usage
- latency_ms
- fallback_count
- validation_result
- request_id
共通化しすぎない
OpenAI・Anthropic・Googleは、利用できる機能もパラメータも同一ではありません。
共通インターフェースには全Providerで必要な最小機能だけを置き、構造化出力、tool calling、画像入力などはCapabilityや拡張設定として扱う方が安全です。
AIProviderインターフェースを作る
初期版の共通メソッドは、テキスト生成を担当する generate() だけに絞ります。
health_check()、Streaming、tool calling、画像入力などを最初から共通化すると、Providerごとの差を無理に隠す設計になりやすいためです。
typing.Protocolを使う理由
- 明示的な継承を強制しない
- FakeProviderを作りやすい
- SDKとの結合を弱められる
- UseCaseから実装詳細を隠せる
発展機能として扱うもの
- health_check()
- supports()によるCapability判定
- Streaming
- tool calling
- 画像・音声・ファイル入力
各Provider Adapterの責務
OpenAIProvider、AnthropicProvider、GeminiProviderは、SDKを呼ぶだけの薄いラッパーではありません。
Provider固有の形式を共通AIResponseへ変換し、上位層へSDK型を漏らさない境界として使います。
リクエスト変換
system instruction、最大出力、温度、出力形式の指示を各SDKへ合わせます。
レスポンス変換
本文、finish reason、使用量、request IDを共通AIResponseへ変換します。
エラー変換
各SDKの例外を、認証・一時障害・モデル利用不可などの共通分類へ変換します。
共通インターフェースは「同じ品質」を保証しない
同じAIRequestを渡しても、各Providerの出力品質・安全制限・パラメータ対応は異なります。
Adapterは差分を吸収しますが、結果を同一にするものではありません。
フォールバック対象のエラーを分類する
すべてのエラーで別Providerへ切り替えればよいわけではありません。
認証設定の誤りや不正入力は、別Providerへ送っても根本原因が解決しないためです。
| エラー | 最初の対応 | 別Provider | 理由 |
|---|---|---|---|
| 接続エラー | 同一Providerを短く再試行 | 再試行後に可 | 一時障害の可能性がある |
| タイムアウト | 総時間予算内で再試行 | 再試行後に可 | Provider側の遅延かもしれない |
| 一時的な5xx・過負荷 | 短いバックオフ | 可 | Provider固有の一時障害 |
| レート制限 | 制限内容を確認 | 条件付きで可 | 短期制限と請求上限では意味が違う |
| モデル利用不可・終了 | 設定を確認 | 可 | 別Provider・別モデルで継続可能 |
| APIキー不正 | 設定修正 | 原則不可 | 運用設定の不備を隠すため |
| 不正入力 | 入力修正 | 不可 | 別Providerでも失敗しやすい |
| ポリシー拒否 | 人間確認 | 原則不可 | 安全措置の迂回を避ける |
| DB保存エラー | アプリ側を修正 | 不可 | AI Providerの問題ではない |
| 出力検証失敗 | 修正指示付き再生成 | 再失敗時に検討 | 形式崩れと品質不足を分ける |
429や404は、ステータスコードだけで判断しない
同じ429でも、短期的なレート制限、月間クォータ超過、請求上限、急激なアクセス増加では対応が違います。
404も、モデル終了ならフォールバック候補ですが、URLやモデル名の設定ミスなら先に設定を修正すべきです。
SDKの自動再試行と二重化しない
公式SDKが内部で再試行する設定になっている場合、Router側でも再試行すると、待ち時間とAPI料金が想定以上に増える可能性があります。
この記事の最小実装では、Provider SDK側の再試行を無効化し、アプリ側のFallbackPolicyで回数を管理します。
FallbackPolicyをRouterから分ける
AIProviderRouterの役割は、Providerを順番に呼び出すことです。
どのエラーで再試行・切り替え・停止するかの判断は、FallbackPolicyへ分けます。
RETRY_SAME
同じProviderを短く再試行します。
NEXT_PROVIDER
次のProviderへ切り替えます。
STOP
自動処理を止め、エラーまたは人間確認へ戻します。
出力形式を検証してから上位処理へ渡す
フォールバックに成功しても、代替Providerの出力が業務要件を満たすとは限りません。
最低限確認したい項目
- 空レスポンスではないか
- 必須フィールドが存在するか
- JSON Schemaに合っているか
- 指定したHTMLタグが含まれているか
- scriptなど禁止タグが入っていないか
- 不正・未知のURLが含まれていないか
- 文字数が極端に短くないか
- 想定言語で書かれているか
- Provider自身の説明文が混入していないか
| 確認工程 | 主に見るもの | 例 |
|---|---|---|
| OutputValidator | 機械的な形式・必須条件 | JSON解析、必須キー、HTMLタグ、文字数 |
| 内部レビュー | 意味・品質・実務上の妥当性 | 検索意図、誤解、リスク、CTA、読者価値 |
Provider切り替え後の品質を保つ考え方は、 AIツールに内部レビュー工程を入れる方法 で詳しく整理しています。
HTMLやSEOレビューを含む具体例は、 AI記事制作ツールを個人開発する方法 も参考にしてください。
ログに残すべき情報
Provider切り替えを運用するには、どのProviderが成功し、どこで失敗し、最終的に何を採用したかを追える必要があります。
保存したい情報
- Provider・モデル
- 開始・終了時刻と処理時間
- 成功・失敗と共通エラー分類
- Provider固有エラーコード・request ID
- 再試行回数・フォールバック回数
- トークン使用量・推定コスト
- 出力検証結果
- 最終採用Provider
- 人間による採用・却下・修正
機密情報を無条件に保存しない
APIキー、プロンプト全文、個人情報、顧客問い合わせ全文、社内機密をそのままログへ残さないでください。
必要に応じてマスキング、要約、ハッシュ化を使い、保存期間・アクセス権・削除方針も決めます。
全Providerが使えない場合は縮退運転へ切り替える
| 状態 | AI記事制作ツール | LINE Bot | コードレビュー |
|---|---|---|---|
| 通常運転 | 第一候補モデルで生成・レビュー | AIが問い合わせへ回答 | AIがコードをレビュー |
| フォールバック | 別Providerで生成 | 別Providerで回答 | 軽量モデルで簡易レビュー |
| 縮退運転 | 保存済み構成・手動編集・HTML出力だけ維持 | 固定FAQ・営業時間・人間対応を案内 | 静的解析だけ実行し、人間レビュー待ちへ送る |
LINE BotでAI停止時の固定回答や人間対応を考える場合は、 LINE Bot完全ガイド も応用例として使えます。
FastAPI・Pythonへ組み込む最小実装
Python 3.12、FastAPI、pydantic-settings、typing.Protocol、各社公式Python SDK、pytest、pytest-asyncioを使う最小例です。
モデル名・対応パラメータ・エラー仕様は変わるため、公開・実装時点の公式ドキュメントを必ず確認してください。
先にFakeProviderで処理を通す
本番APIをつなぐ前に、FakeProviderでRoute → UseCase → Router → Validator → Logの接続を確認します。
実装順は AI API連携はいつ入れるべき? でも整理しています。
インストール例
pip install fastapi uvicorn pydantic-settings openai anthropic google-genai pytest pytest-asyncioファイル構成
app/
├── domain/
│   ├── models.py
│   └── errors.py
├── ports/
│   ├── ai_provider.py
│   └── provider_log_repository.py
├── providers/
│   ├── error_mapping.py
│   ├── openai_provider.py
│   ├── anthropic_provider.py
│   └── gemini_provider.py
├── services/
│   ├── fallback_policy.py
│   ├── output_validator.py
│   └── provider_router.py
├── infrastructure/
│   └── logging_repository.py
├── usecases/
│   └── generate_content.py
├── api/
│   └── routes.py
├── tests/
│   ├── fakes.py
│   └── test_provider_router.py
├── settings.py
├── dependencies.py
└── main.py
1. app/domain/models.py
from __future__ import annotations

from dataclasses import dataclass, field
from datetime import datetime
from typing import Any, Literal

ResponseFormat = Literal["text", "json", "html"]


@dataclass(frozen=True, slots=True)
class AIRequest:
    system_instruction: str
    user_input: str
    temperature: float = 0.2
    max_output_tokens: int = 1_500
    response_format: ResponseFormat = "text"
    metadata: dict[str, Any] = field(default_factory=dict)


@dataclass(frozen=True, slots=True)
class UsageMetrics:
    input_tokens: int | None = None
    output_tokens: int | None = None
    estimated_cost: float | None = None


@dataclass(frozen=True, slots=True)
class ValidationResult:
    is_valid: bool
    issues: tuple[str, ...] = ()


@dataclass(frozen=True, slots=True)
class AIResponse:
    content: str
    provider: str
    model: str
    finish_reason: str | None
    usage: UsageMetrics
    latency_ms: int
    fallback_count: int = 0
    validation_result: ValidationResult | None = None
    request_id: str | None = None


@dataclass(frozen=True, slots=True)
class ProviderAttemptLog:
    operation_id: str
    provider: str
    model: str
    attempt_in_provider: int
    fallback_count: int
    started_at: datetime
    ended_at: datetime
    latency_ms: int
    success: bool
    error_kind: str | None = None
    provider_error_code: str | None = None
    request_id: str | None = None
    input_tokens: int | None = None
    output_tokens: int | None = None
    validation_succeeded: bool | None = None
2. app/domain/errors.py
from __future__ import annotations

from enum import StrEnum
from typing import Sequence


class ProviderErrorKind(StrEnum):
    CONNECTION = "connection"
    TIMEOUT = "timeout"
    RATE_LIMIT = "rate_limit"
    SERVER = "server"
    OVERLOADED = "overloaded"
    MODEL_UNAVAILABLE = "model_unavailable"
    AUTHENTICATION = "authentication"
    PERMISSION = "permission"
    BILLING = "billing"
    INVALID_REQUEST = "invalid_request"
    INPUT_TOO_LARGE = "input_too_large"
    POLICY_REFUSAL = "policy_refusal"
    CANCELLED = "cancelled"
    OUTPUT_VALIDATION = "output_validation"
    UNKNOWN = "unknown"


class AIProviderError(Exception):
    def __init__(
        self,
        *,
        provider: str,
        kind: ProviderErrorKind,
        message: str,
        status_code: int | None = None,
        provider_code: str | None = None,
        request_id: str | None = None,
    ) -> None:
        super().__init__(message)
        self.provider = provider
        self.kind = kind
        self.status_code = status_code
        self.provider_code = provider_code
        self.request_id = request_id


class AllProvidersFailedError(RuntimeError):
    def __init__(self, errors: Sequence[AIProviderError]) -> None:
        super().__init__("利用可能なAI Providerで処理を完了できませんでした。")
        self.errors = tuple(errors)
3. app/ports/ai_provider.py
from typing import Protocol

from app.domain.models import AIRequest, AIResponse


class AIProvider(Protocol):
    name: str
    model: str

    async def generate(self, request: AIRequest) -> AIResponse:
        ...
4. app/ports/provider_log_repository.py
from typing import Protocol

from app.domain.models import ProviderAttemptLog


class ProviderLogRepository(Protocol):
    async def save(self, log: ProviderAttemptLog) -> None:
        ...
5. app/providers/error_mapping.py
from __future__ import annotations

import anthropic
import openai
from google.genai import errors as gemini_errors

from app.domain.errors import AIProviderError, ProviderErrorKind


def _message_contains(message: str, *keywords: str) -> bool:
    lowered = message.lower()
    return any(keyword in lowered for keyword in keywords)


def _classify_rate_limit(message: str) -> ProviderErrorKind:
    # 429でも、短期的な混雑と請求・上限超過では対応が違います。
    if _message_contains(
        message,
        "insufficient_quota",
        "billing",
        "hard limit",
        "payment required",
    ):
        return ProviderErrorKind.BILLING
    return ProviderErrorKind.RATE_LIMIT


def _classify_not_found(message: str) -> ProviderErrorKind:
    # モデル廃止・利用不可と、URLや設定ミスを同じ404として扱わないための簡易分類です。
    if _message_contains(message, "model", "not found", "does not exist"):
        return ProviderErrorKind.MODEL_UNAVAILABLE
    return ProviderErrorKind.INVALID_REQUEST


def map_openai_error(exc: openai.APIError, provider: str) -> AIProviderError:
    message = str(exc)
    status_code = getattr(exc, "status_code", None)
    request_id = getattr(exc, "request_id", None)

    if isinstance(exc, openai.APITimeoutError):
        kind = ProviderErrorKind.TIMEOUT
    elif isinstance(exc, openai.APIConnectionError):
        kind = ProviderErrorKind.CONNECTION
    elif isinstance(exc, openai.AuthenticationError):
        kind = ProviderErrorKind.AUTHENTICATION
    elif isinstance(exc, openai.PermissionDeniedError):
        kind = ProviderErrorKind.PERMISSION
    elif isinstance(exc, openai.RateLimitError):
        kind = _classify_rate_limit(message)
    elif isinstance(exc, openai.NotFoundError):
        kind = _classify_not_found(message)
    elif isinstance(exc, (openai.BadRequestError, openai.UnprocessableEntityError)):
        kind = ProviderErrorKind.INVALID_REQUEST
    elif isinstance(exc, openai.InternalServerError):
        kind = ProviderErrorKind.SERVER
    else:
        kind = ProviderErrorKind.UNKNOWN

    return AIProviderError(
        provider=provider,
        kind=kind,
        message=message,
        status_code=status_code,
        provider_code=str(status_code) if status_code is not None else None,
        request_id=request_id,
    )


def map_anthropic_error(
    exc: anthropic.APIError,
    provider: str,
) -> AIProviderError:
    message = str(exc)
    status_code = getattr(exc, "status_code", None)
    request_id = getattr(exc, "request_id", None)

    if isinstance(exc, anthropic.APITimeoutError):
        kind = ProviderErrorKind.TIMEOUT
    elif isinstance(exc, anthropic.APIConnectionError):
        kind = ProviderErrorKind.CONNECTION
    elif isinstance(exc, anthropic.AuthenticationError):
        kind = ProviderErrorKind.AUTHENTICATION
    elif isinstance(exc, anthropic.PermissionDeniedError):
        kind = ProviderErrorKind.PERMISSION
    elif isinstance(exc, anthropic.RateLimitError):
        kind = _classify_rate_limit(message)
    elif isinstance(exc, anthropic.NotFoundError):
        kind = _classify_not_found(message)
    elif isinstance(exc, (anthropic.BadRequestError, anthropic.UnprocessableEntityError)):
        kind = ProviderErrorKind.INVALID_REQUEST
    elif isinstance(exc, anthropic.InternalServerError):
        kind = ProviderErrorKind.SERVER
    else:
        kind = ProviderErrorKind.UNKNOWN

    return AIProviderError(
        provider=provider,
        kind=kind,
        message=message,
        status_code=status_code,
        provider_code=str(status_code) if status_code is not None else None,
        request_id=request_id,
    )


def map_gemini_error(
    exc: gemini_errors.APIError,
    provider: str,
) -> AIProviderError:
    status_code = getattr(exc, "code", None)
    message = getattr(exc, "message", str(exc))

    if status_code == 401:
        kind = ProviderErrorKind.AUTHENTICATION
    elif status_code == 403:
        kind = ProviderErrorKind.PERMISSION
    elif status_code == 404:
        kind = _classify_not_found(message)
    elif status_code in {408, 504}:
        kind = ProviderErrorKind.TIMEOUT
    elif status_code == 429:
        kind = _classify_rate_limit(message)
    elif status_code is not None and status_code >= 500:
        kind = ProviderErrorKind.SERVER
    elif status_code in {400, 422}:
        kind = ProviderErrorKind.INVALID_REQUEST
    else:
        kind = ProviderErrorKind.UNKNOWN

    return AIProviderError(
        provider=provider,
        kind=kind,
        message=message,
        status_code=status_code,
        provider_code=str(status_code) if status_code is not None else None,
    )
6. app/providers/openai_provider.py
from __future__ import annotations

from time import perf_counter

import openai
from openai import AsyncOpenAI

from app.domain.errors import AIProviderError, ProviderErrorKind
from app.domain.models import AIRequest, AIResponse, UsageMetrics
from app.providers.error_mapping import map_openai_error


class OpenAIProvider:
    name = "openai"

    def __init__(
        self,
        *,
        api_key: str,
        model: str,
        timeout_seconds: float,
    ) -> None:
        self.model = model
        self._client = AsyncOpenAI(
            api_key=api_key,
            timeout=timeout_seconds,
            max_retries=0,
        )

    async def generate(self, request: AIRequest) -> AIResponse:
        started = perf_counter()
        instructions = _build_instructions(request)

        try:
            response = await self._client.responses.create(
                model=self.model,
                instructions=instructions or None,
                input=request.user_input,
                max_output_tokens=request.max_output_tokens,
            )
        except openai.APIError as exc:
            raise map_openai_error(exc, self.name) from exc

        refusal = _extract_refusal(response)
        if refusal is not None:
            raise AIProviderError(
                provider=self.name,
                kind=ProviderErrorKind.POLICY_REFUSAL,
                message=refusal,
                request_id=getattr(response, "_request_id", None),
            )

        usage = getattr(response, "usage", None)
        return AIResponse(
            content=response.output_text or "",
            provider=self.name,
            model=self.model,
            finish_reason=getattr(response, "status", None),
            usage=UsageMetrics(
                input_tokens=getattr(usage, "input_tokens", None),
                output_tokens=getattr(usage, "output_tokens", None),
            ),
            latency_ms=int((perf_counter() - started) * 1_000),
            request_id=getattr(response, "_request_id", None),
        )


def _build_instructions(request: AIRequest) -> str:
    format_instruction = {
        "text": "プレーンテキストで返してください。",
        "json": "コードフェンスを使わず、有効なJSONだけを返してください。",
        "html": "説明文やコードフェンスを付けず、HTML断片だけを返してください。",
    }[request.response_format]
    return "\n\n".join(
        part for part in (request.system_instruction.strip(), format_instruction) if part
    )


def _extract_refusal(response: object) -> str | None:
    # Responses APIの出力を汎用的に走査し、refusalを別Providerへ自動転送しないよう検出します。
    for item in getattr(response, "output", ()) or ():
        for part in getattr(item, "content", ()) or ():
            if getattr(part, "type", None) == "refusal":
                return getattr(part, "refusal", None) or "OpenAIが応答を拒否しました。"
    return None
7. app/providers/anthropic_provider.py
from __future__ import annotations

from time import perf_counter

import anthropic
from anthropic import AsyncAnthropic

from app.domain.errors import AIProviderError, ProviderErrorKind
from app.domain.models import AIRequest, AIResponse, UsageMetrics
from app.providers.error_mapping import map_anthropic_error


class AnthropicProvider:
    name = "anthropic"

    def __init__(
        self,
        *,
        api_key: str,
        model: str,
        timeout_seconds: float,
    ) -> None:
        self.model = model
        self._client = AsyncAnthropic(
            api_key=api_key,
            timeout=timeout_seconds,
            max_retries=0,
        )

    async def generate(self, request: AIRequest) -> AIResponse:
        started = perf_counter()
        system = _build_system_instruction(request)

        try:
            message = await self._client.messages.create(
                model=self.model,
                max_tokens=request.max_output_tokens,
                temperature=request.temperature,
                system=system,
                messages=[{"role": "user", "content": request.user_input}],
            )
        except anthropic.APIError as exc:
            raise map_anthropic_error(exc, self.name) from exc

        if getattr(message, "stop_reason", None) == "refusal":
            raise AIProviderError(
                provider=self.name,
                kind=ProviderErrorKind.POLICY_REFUSAL,
                message="Anthropicが応答を拒否しました。",
                request_id=getattr(message, "_request_id", None),
            )

        content = "".join(
            block.text
            for block in message.content
            if getattr(block, "type", None) == "text"
        )

        return AIResponse(
            content=content,
            provider=self.name,
            model=self.model,
            finish_reason=message.stop_reason,
            usage=UsageMetrics(
                input_tokens=message.usage.input_tokens,
                output_tokens=message.usage.output_tokens,
            ),
            latency_ms=int((perf_counter() - started) * 1_000),
            request_id=getattr(message, "_request_id", None),
        )


def _build_system_instruction(request: AIRequest) -> str:
    format_instruction = {
        "text": "プレーンテキストで返してください。",
        "json": "コードフェンスを使わず、有効なJSONだけを返してください。",
        "html": "説明文やコードフェンスを付けず、HTML断片だけを返してください。",
    }[request.response_format]
    return "\n\n".join(
        part for part in (request.system_instruction.strip(), format_instruction) if part
    )
8. app/providers/gemini_provider.py
from __future__ import annotations

from time import perf_counter

from google import genai
from google.genai import errors as gemini_errors
from google.genai import types

from app.domain.errors import AIProviderError, ProviderErrorKind
from app.domain.models import AIRequest, AIResponse, UsageMetrics
from app.providers.error_mapping import map_gemini_error


class GeminiProvider:
    name = "gemini"

    def __init__(
        self,
        *,
        api_key: str,
        model: str,
        timeout_seconds: float,
    ) -> None:
        self.model = model
        self._client = genai.Client(
            api_key=api_key,
            http_options=types.HttpOptions(
                # google-genaiのtimeoutはミリ秒です。
                timeout=int(timeout_seconds * 1_000),
                # 初回リクエストだけにし、Router側Policyと再試行を二重化しません。
                retry_options=types.HttpRetryOptions(attempts=1),
            ),
        )

    async def generate(self, request: AIRequest) -> AIResponse:
        started = perf_counter()

        try:
            response = await self._client.aio.models.generate_content(
                model=self.model,
                contents=request.user_input,
                config=types.GenerateContentConfig(
                    system_instruction=_build_system_instruction(request),
                    max_output_tokens=request.max_output_tokens,
                    temperature=request.temperature,
                ),
            )
        except gemini_errors.APIError as exc:
            raise map_gemini_error(exc, self.name) from exc

        prompt_feedback = getattr(response, "prompt_feedback", None)
        if getattr(prompt_feedback, "block_reason", None):
            raise AIProviderError(
                provider=self.name,
                kind=ProviderErrorKind.POLICY_REFUSAL,
                message=(
                    getattr(prompt_feedback, "block_reason_message", None)
                    or "Geminiが応答を拒否しました。"
                ),
                request_id=getattr(response, "response_id", None),
            )

        candidate = response.candidates[0] if response.candidates else None
        finish_reason = getattr(candidate, "finish_reason", None)
        if str(finish_reason).upper().endswith(
            ("SAFETY", "BLOCKLIST", "PROHIBITED_CONTENT")
        ):
            raise AIProviderError(
                provider=self.name,
                kind=ProviderErrorKind.POLICY_REFUSAL,
                message="Geminiの安全設定により応答が停止しました。",
                request_id=getattr(response, "response_id", None),
            )

        usage = getattr(response, "usage_metadata", None)
        return AIResponse(
            content=response.text or "",
            provider=self.name,
            model=self.model,
            finish_reason=str(finish_reason) if finish_reason is not None else None,
            usage=UsageMetrics(
                input_tokens=getattr(usage, "prompt_token_count", None),
                output_tokens=getattr(usage, "candidates_token_count", None),
            ),
            latency_ms=int((perf_counter() - started) * 1_000),
            request_id=getattr(response, "response_id", None),
        )


def _build_system_instruction(request: AIRequest) -> str:
    format_instruction = {
        "text": "プレーンテキストで返してください。",
        "json": "コードフェンスを使わず、有効なJSONだけを返してください。",
        "html": "説明文やコードフェンスを付けず、HTML断片だけを返してください。",
    }[request.response_format]
    return "\n\n".join(
        part for part in (request.system_instruction.strip(), format_instruction) if part
    )
9. app/services/fallback_policy.py
from dataclasses import dataclass
from enum import StrEnum

from app.domain.errors import AIProviderError, ProviderErrorKind


class FailureAction(StrEnum):
    RETRY_SAME = "retry_same"
    NEXT_PROVIDER = "next_provider"
    STOP = "stop"


@dataclass(frozen=True, slots=True)
class FallbackPolicy:
    max_attempts_per_provider: int = 2
    base_backoff_seconds: float = 0.4

    def decide(
        self,
        *,
        error: AIProviderError,
        attempt_in_provider: int,
        has_next_provider: bool,
    ) -> FailureAction:
        stop_kinds = {
            ProviderErrorKind.AUTHENTICATION,
            ProviderErrorKind.PERMISSION,
            ProviderErrorKind.BILLING,
            ProviderErrorKind.INVALID_REQUEST,
            ProviderErrorKind.INPUT_TOO_LARGE,
            ProviderErrorKind.POLICY_REFUSAL,
            ProviderErrorKind.CANCELLED,
            ProviderErrorKind.UNKNOWN,
        }
        if error.kind in stop_kinds:
            return FailureAction.STOP

        if error.kind == ProviderErrorKind.MODEL_UNAVAILABLE:
            return FailureAction.NEXT_PROVIDER if has_next_provider else FailureAction.STOP

        retryable_kinds = {
            ProviderErrorKind.CONNECTION,
            ProviderErrorKind.TIMEOUT,
            ProviderErrorKind.RATE_LIMIT,
            ProviderErrorKind.SERVER,
            ProviderErrorKind.OVERLOADED,
            ProviderErrorKind.OUTPUT_VALIDATION,
        }
        if error.kind in retryable_kinds:
            if attempt_in_provider < self.max_attempts_per_provider:
                return FailureAction.RETRY_SAME
            return FailureAction.NEXT_PROVIDER if has_next_provider else FailureAction.STOP

        return FailureAction.STOP

    def backoff_seconds(self, attempt_in_provider: int) -> float:
        return self.base_backoff_seconds * (2 ** max(0, attempt_in_provider - 1))
10. app/services/output_validator.py
from __future__ import annotations

import json
import re
from dataclasses import replace
from html.parser import HTMLParser
from urllib.parse import urlparse

from app.domain.models import AIRequest, AIResponse, ValidationResult


class _HTMLInspectionParser(HTMLParser):
    def __init__(self) -> None:
        super().__init__()
        self.tags: list[str] = []
        self.urls: list[str] = []

    def handle_starttag(
        self,
        tag: str,
        attrs: list[tuple[str, str | None]],
    ) -> None:
        self.tags.append(tag.lower())
        for name, value in attrs:
            if name.lower() in {"href", "src"} and value:
                self.urls.append(value)


class OutputValidator:
    def __init__(self, *, min_length: int = 20) -> None:
        self.min_length = min_length

    def validate(
        self,
        request: AIRequest,
        response: AIResponse,
    ) -> ValidationResult:
        issues: list[str] = []
        content = response.content.strip()

        if not content:
            issues.append("出力が空です。")
            return ValidationResult(False, tuple(issues))

        if len(content) < self.min_length:
            issues.append("出力が想定より短すぎます。")

        if request.response_format == "json":
            self._validate_json(content, request, issues)
        elif request.response_format == "html":
            self._validate_html(content, request, issues)

        expected_language = request.metadata.get("expected_language")
        if expected_language == "ja" and not re.search(r"[ぁ-んァ-ヶ一-龠]", content):
            issues.append("日本語として判定できる文字が不足しています。")

        contamination_patterns = (
            "as an ai language model",
            "i cannot comply with that request",
            "here is the requested html",
        )
        lowered = content.lower()
        if any(pattern in lowered for pattern in contamination_patterns):
            issues.append("Provider固有の説明文が混入している可能性があります。")

        return ValidationResult(is_valid=not issues, issues=tuple(issues))

    def build_repair_request(
        self,
        original: AIRequest,
        invalid_response: AIResponse,
        validation: ValidationResult,
    ) -> AIRequest:
        # 前回出力を無制限に再送するとコストが増えるため、最小例では長さを制限します。
        previous = invalid_response.content[:6_000]
        issues = "\n".join(f"- {issue}" for issue in validation.issues)
        repair_input = f"""次の出力を要件に合うよう修正してください。

問題点:
{issues}

前回出力:
{previous}
"""
        return replace(original, user_input=repair_input)

    @staticmethod
    def _validate_json(
        content: str,
        request: AIRequest,
        issues: list[str],
    ) -> None:
        try:
            parsed = json.loads(content)
        except json.JSONDecodeError:
            issues.append("有効なJSONではありません。")
            return

        required_fields = request.metadata.get("required_fields", ())
        if isinstance(parsed, dict):
            for field_name in required_fields:
                if field_name not in parsed:
                    issues.append(f"必須フィールドがありません: {field_name}")

    @staticmethod
    def _validate_html(
        content: str,
        request: AIRequest,
        issues: list[str],
    ) -> None:
        parser = _HTMLInspectionParser()
        parser.feed(content)

        prohibited_tags = {"script", "object", "embed"}
        found_prohibited = sorted(prohibited_tags.intersection(parser.tags))
        if found_prohibited:
            issues.append(
                "禁止タグが含まれています: " + ", ".join(found_prohibited)
            )

        required_tags = request.metadata.get("required_html_tags", ())
        for tag in required_tags:
            if str(tag).lower() not in parser.tags:
                issues.append(f"必須HTMLタグがありません: {tag}")

        for url in parser.urls:
            parsed = urlparse(url)
            if parsed.scheme and parsed.scheme not in {"http", "https"}:
                issues.append(f"許可していないURLスキームです: {parsed.scheme}")
11. app/services/provider_router.py
from __future__ import annotations

import asyncio
from dataclasses import replace
from datetime import datetime, timezone
from time import perf_counter
from uuid import uuid4

from app.domain.errors import (
    AIProviderError,
    AllProvidersFailedError,
    ProviderErrorKind,
)
from app.domain.models import (
    AIRequest,
    AIResponse,
    ProviderAttemptLog,
    UsageMetrics,
    ValidationResult,
)
from app.ports.ai_provider import AIProvider
from app.ports.provider_log_repository import ProviderLogRepository
from app.services.fallback_policy import FailureAction, FallbackPolicy
from app.services.output_validator import OutputValidator


class AIProviderRouter:
    def __init__(
        self,
        *,
        providers: list[AIProvider],
        fallback_policy: FallbackPolicy,
        output_validator: OutputValidator,
        log_repository: ProviderLogRepository,
        provider_timeout_seconds: float,
        total_timeout_seconds: float,
    ) -> None:
        if not providers:
            raise ValueError("少なくとも1つのProviderが必要です。")
        self._providers = providers
        self._policy = fallback_policy
        self._validator = output_validator
        self._logs = log_repository
        self._provider_timeout_seconds = provider_timeout_seconds
        self._total_timeout_seconds = total_timeout_seconds

    async def generate(self, request: AIRequest) -> AIResponse:
        errors: list[AIProviderError] = []
        operation_id = uuid4().hex

        try:
            async with asyncio.timeout(self._total_timeout_seconds):
                return await self._run_providers(request, operation_id, errors)
        except TimeoutError as exc:
            total_timeout_error = AIProviderError(
                provider="router",
                kind=ProviderErrorKind.TIMEOUT,
                message="AI処理全体の制限時間を超えました。",
            )
            errors.append(total_timeout_error)
            raise AllProvidersFailedError(errors) from exc

    async def _run_providers(
        self,
        original_request: AIRequest,
        operation_id: str,
        errors: list[AIProviderError],
    ) -> AIResponse:
        fallback_count = 0

        for provider_index, provider in enumerate(self._providers):
            has_next_provider = provider_index < len(self._providers) - 1
            working_request = original_request
            attempt_in_provider = 0

            while attempt_in_provider < self._policy.max_attempts_per_provider:
                attempt_in_provider += 1
                started_at = datetime.now(timezone.utc)
                started_clock = perf_counter()

                try:
                    async with asyncio.timeout(self._provider_timeout_seconds):
                        raw_response = await provider.generate(working_request)

                    validation = self._validator.validate(
                        original_request,
                        raw_response,
                    )
                    response = replace(
                        raw_response,
                        fallback_count=fallback_count,
                        validation_result=validation,
                    )

                    if validation.is_valid:
                        await self._save_success_log(
                            operation_id=operation_id,
                            provider=provider,
                            response=response,
                            attempt_in_provider=attempt_in_provider,
                            fallback_count=fallback_count,
                            started_at=started_at,
                            started_clock=started_clock,
                        )
                        return response

                    error = AIProviderError(
                        provider=provider.name,
                        kind=ProviderErrorKind.OUTPUT_VALIDATION,
                        message=" / ".join(validation.issues),
                        request_id=response.request_id,
                    )
                    errors.append(error)
                    await self._save_failure_log(
                        operation_id=operation_id,
                        provider=provider,
                        error=error,
                        attempt_in_provider=attempt_in_provider,
                        fallback_count=fallback_count,
                        started_at=started_at,
                        started_clock=started_clock,
                        validation=validation,
                    )
                    action = self._policy.decide(
                        error=error,
                        attempt_in_provider=attempt_in_provider,
                        has_next_provider=has_next_provider,
                    )
                    if action == FailureAction.RETRY_SAME:
                        working_request = self._validator.build_repair_request(
                            original_request,
                            response,
                            validation,
                        )
                        await asyncio.sleep(
                            self._policy.backoff_seconds(attempt_in_provider)
                        )
                        continue
                    if action == FailureAction.NEXT_PROVIDER:
                        break
                    raise AllProvidersFailedError(errors)

                except TimeoutError:
                    error = AIProviderError(
                        provider=provider.name,
                        kind=ProviderErrorKind.TIMEOUT,
                        message="Provider呼び出しがタイムアウトしました。",
                    )
                except AIProviderError as exc:
                    error = exc
                except Exception:
                    # アプリ側の未知のバグは別Providerで隠さず、そのまま上位へ返します。
                    raise

                errors.append(error)
                await self._save_failure_log(
                    operation_id=operation_id,
                    provider=provider,
                    error=error,
                    attempt_in_provider=attempt_in_provider,
                    fallback_count=fallback_count,
                    started_at=started_at,
                    started_clock=started_clock,
                    validation=None,
                )
                action = self._policy.decide(
                    error=error,
                    attempt_in_provider=attempt_in_provider,
                    has_next_provider=has_next_provider,
                )

                if action == FailureAction.RETRY_SAME:
                    await asyncio.sleep(
                        self._policy.backoff_seconds(attempt_in_provider)
                    )
                    continue
                if action == FailureAction.NEXT_PROVIDER:
                    break
                raise AllProvidersFailedError(errors)

            if has_next_provider:
                fallback_count += 1

        raise AllProvidersFailedError(errors)

    async def _save_success_log(
        self,
        *,
        operation_id: str,
        provider: AIProvider,
        response: AIResponse,
        attempt_in_provider: int,
        fallback_count: int,
        started_at: datetime,
        started_clock: float,
    ) -> None:
        await self._logs.save(
            ProviderAttemptLog(
                operation_id=operation_id,
                provider=provider.name,
                model=provider.model,
                attempt_in_provider=attempt_in_provider,
                fallback_count=fallback_count,
                started_at=started_at,
                ended_at=datetime.now(timezone.utc),
                latency_ms=int((perf_counter() - started_clock) * 1_000),
                success=True,
                request_id=response.request_id,
                input_tokens=response.usage.input_tokens,
                output_tokens=response.usage.output_tokens,
                validation_succeeded=True,
            )
        )

    async def _save_failure_log(
        self,
        *,
        operation_id: str,
        provider: AIProvider,
        error: AIProviderError,
        attempt_in_provider: int,
        fallback_count: int,
        started_at: datetime,
        started_clock: float,
        validation: ValidationResult | None,
    ) -> None:
        await self._logs.save(
            ProviderAttemptLog(
                operation_id=operation_id,
                provider=provider.name,
                model=provider.model,
                attempt_in_provider=attempt_in_provider,
                fallback_count=fallback_count,
                started_at=started_at,
                ended_at=datetime.now(timezone.utc),
                latency_ms=int((perf_counter() - started_clock) * 1_000),
                success=False,
                error_kind=error.kind.value,
                provider_error_code=error.provider_code,
                request_id=error.request_id,
                validation_succeeded=(
                    validation.is_valid if validation is not None else None
                ),
            )
        )
12. app/infrastructure/logging_repository.py
from __future__ import annotations

import asyncio

from app.domain.models import ProviderAttemptLog


class InMemoryProviderLogRepository:
    def __init__(self) -> None:
        self._items: list[ProviderAttemptLog] = []
        self._lock = asyncio.Lock()

    async def save(self, log: ProviderAttemptLog) -> None:
        async with self._lock:
            self._items.append(log)

    async def list_all(self) -> tuple[ProviderAttemptLog, ...]:
        async with self._lock:
            return tuple(self._items)
13. app/usecases/generate_content.py
from app.domain.models import AIRequest, AIResponse
from app.services.provider_router import AIProviderRouter


class GenerateContentUseCase:
    def __init__(self, router: AIProviderRouter) -> None:
        self._router = router

    async def execute(self, request: AIRequest) -> AIResponse:
        return await self._router.generate(request)
14. app/settings.py
from functools import lru_cache

from pydantic import SecretStr
from pydantic_settings import BaseSettings, SettingsConfigDict


class Settings(BaseSettings):
    openai_api_key: SecretStr | None = None
    anthropic_api_key: SecretStr | None = None
    gemini_api_key: SecretStr | None = None

    openai_model: str | None = None
    anthropic_model: str | None = None
    gemini_model: str | None = None

    provider_order: str = "openai,anthropic,gemini"
    provider_timeout_seconds: float = 20.0
    total_timeout_seconds: float = 45.0
    max_attempts_per_provider: int = 2

    model_config = SettingsConfigDict(
        env_file=".env",
        env_file_encoding="utf-8",
        extra="ignore",
    )


@lru_cache
def get_settings() -> Settings:
    return Settings()
15. app/dependencies.py
from functools import lru_cache

from app.infrastructure.logging_repository import InMemoryProviderLogRepository
from app.ports.ai_provider import AIProvider
from app.providers.anthropic_provider import AnthropicProvider
from app.providers.gemini_provider import GeminiProvider
from app.providers.openai_provider import OpenAIProvider
from app.services.fallback_policy import FallbackPolicy
from app.services.output_validator import OutputValidator
from app.services.provider_router import AIProviderRouter
from app.settings import get_settings
from app.usecases.generate_content import GenerateContentUseCase


@lru_cache
def get_log_repository() -> InMemoryProviderLogRepository:
    return InMemoryProviderLogRepository()


@lru_cache
def get_generate_content_use_case() -> GenerateContentUseCase:
    settings = get_settings()
    providers_by_name: dict[str, AIProvider] = {}

    if settings.openai_api_key and settings.openai_model:
        providers_by_name["openai"] = OpenAIProvider(
            api_key=settings.openai_api_key.get_secret_value(),
            model=settings.openai_model,
            timeout_seconds=settings.provider_timeout_seconds,
        )

    if settings.anthropic_api_key and settings.anthropic_model:
        providers_by_name["anthropic"] = AnthropicProvider(
            api_key=settings.anthropic_api_key.get_secret_value(),
            model=settings.anthropic_model,
            timeout_seconds=settings.provider_timeout_seconds,
        )

    if settings.gemini_api_key and settings.gemini_model:
        providers_by_name["gemini"] = GeminiProvider(
            api_key=settings.gemini_api_key.get_secret_value(),
            model=settings.gemini_model,
            timeout_seconds=settings.provider_timeout_seconds,
        )

    ordered_names = [
        name.strip()
        for name in settings.provider_order.split(",")
        if name.strip()
    ]
    providers = [
        providers_by_name[name]
        for name in ordered_names
        if name in providers_by_name
    ]
    if not providers:
        raise RuntimeError(
            "APIキーとモデル名が設定されたProviderがありません。"
        )

    router = AIProviderRouter(
        providers=providers,
        fallback_policy=FallbackPolicy(
            max_attempts_per_provider=settings.max_attempts_per_provider
        ),
        output_validator=OutputValidator(),
        log_repository=get_log_repository(),
        provider_timeout_seconds=settings.provider_timeout_seconds,
        total_timeout_seconds=settings.total_timeout_seconds,
    )
    return GenerateContentUseCase(router)
16. app/api/routes.py
from typing import Annotated, Any, Literal

from fastapi import APIRouter, Depends, HTTPException, status
from pydantic import BaseModel, Field

from app.dependencies import get_generate_content_use_case
from app.domain.errors import AllProvidersFailedError
from app.domain.models import AIRequest
from app.usecases.generate_content import GenerateContentUseCase

router = APIRouter(prefix="/api/ai", tags=["ai"])


class GenerateRequestBody(BaseModel):
    system_instruction: str = ""
    user_input: str = Field(min_length=1, max_length=100_000)
    temperature: float = Field(default=0.2, ge=0.0, le=2.0)
    max_output_tokens: int = Field(default=1_500, ge=1, le=32_000)
    response_format: Literal["text", "json", "html"] = "text"
    metadata: dict[str, Any] = Field(default_factory=dict)


class GenerateResponseBody(BaseModel):
    content: str
    provider: str
    model: str
    finish_reason: str | None
    fallback_count: int
    latency_ms: int
    request_id: str | None
    validation_succeeded: bool | None


@router.post("/generate", response_model=GenerateResponseBody)
async def generate_content(
    body: GenerateRequestBody,
    use_case: Annotated[
        GenerateContentUseCase,
        Depends(get_generate_content_use_case),
    ],
) -> GenerateResponseBody:
    try:
        result = await use_case.execute(
            AIRequest(
                system_instruction=body.system_instruction,
                user_input=body.user_input,
                temperature=body.temperature,
                max_output_tokens=body.max_output_tokens,
                response_format=body.response_format,
                metadata=body.metadata,
            )
        )
    except AllProvidersFailedError as exc:
        raise HTTPException(
            status_code=status.HTTP_503_SERVICE_UNAVAILABLE,
            detail="現在AI生成を利用できません。時間を置くか手動処理へ切り替えてください。",
        ) from exc

    return GenerateResponseBody(
        content=result.content,
        provider=result.provider,
        model=result.model,
        finish_reason=result.finish_reason,
        fallback_count=result.fallback_count,
        latency_ms=result.latency_ms,
        request_id=result.request_id,
        validation_succeeded=(
            result.validation_result.is_valid
            if result.validation_result is not None
            else None
        ),
    )
17. app/main.py
from fastapi import FastAPI

from app.api.routes import router as ai_router

app = FastAPI(title="AI Provider Fallback Example")
app.include_router(ai_router)
18. app/tests/fakes.py
from __future__ import annotations

from collections import deque

from app.domain.models import AIRequest, AIResponse, UsageMetrics


class FakeProvider:
    def __init__(
        self,
        *,
        name: str,
        model: str,
        outcomes: list[AIResponse | Exception],
    ) -> None:
        self.name = name
        self.model = model
        self._outcomes = deque(outcomes)
        self.call_count = 0

    async def generate(self, request: AIRequest) -> AIResponse:
        self.call_count += 1
        if not self._outcomes:
            raise AssertionError("FakeProviderの結果が不足しています。")
        outcome = self._outcomes.popleft()
        if isinstance(outcome, Exception):
            raise outcome
        return outcome


def make_response(
    *,
    provider: str,
    model: str,
    content: str = "十分な長さのテスト応答です。",
) -> AIResponse:
    return AIResponse(
        content=content,
        provider=provider,
        model=model,
        finish_reason="stop",
        usage=UsageMetrics(input_tokens=10, output_tokens=20),
        latency_ms=10,
        request_id="test-request-id",
    )
19. app/tests/test_provider_router.py
from __future__ import annotations

import asyncio

import pytest

from app.domain.errors import (
    AIProviderError,
    AllProvidersFailedError,
    ProviderErrorKind,
)
from app.domain.models import AIRequest
from app.infrastructure.logging_repository import InMemoryProviderLogRepository
from app.services.fallback_policy import FallbackPolicy
from app.services.output_validator import OutputValidator
from app.services.provider_router import AIProviderRouter
from app.tests.fakes import FakeProvider, make_response


def make_request() -> AIRequest:
    return AIRequest(
        system_instruction="日本語で回答してください。",
        user_input="Provider抽象化を説明してください。",
        metadata={"expected_language": "ja"},
    )


def make_router(
    providers: list[FakeProvider],
    *,
    provider_timeout_seconds: float = 0.2,
    total_timeout_seconds: float = 1.0,
) -> AIProviderRouter:
    return AIProviderRouter(
        providers=providers,
        fallback_policy=FallbackPolicy(
            max_attempts_per_provider=1,
            base_backoff_seconds=0.0,
        ),
        output_validator=OutputValidator(min_length=10),
        log_repository=InMemoryProviderLogRepository(),
        provider_timeout_seconds=provider_timeout_seconds,
        total_timeout_seconds=total_timeout_seconds,
    )


@pytest.mark.asyncio
async def test_primary_provider_succeeds() -> None:
    primary = FakeProvider(
        name="primary",
        model="model-a",
        outcomes=[make_response(provider="primary", model="model-a")],
    )
    secondary = FakeProvider(
        name="secondary",
        model="model-b",
        outcomes=[make_response(provider="secondary", model="model-b")],
    )

    result = await make_router([primary, secondary]).generate(make_request())

    assert result.provider == "primary"
    assert result.fallback_count == 0
    assert secondary.call_count == 0


@pytest.mark.asyncio
async def test_timeout_falls_back_to_secondary() -> None:
    primary = FakeProvider(
        name="primary",
        model="model-a",
        outcomes=[
            AIProviderError(
                provider="primary",
                kind=ProviderErrorKind.TIMEOUT,
                message="timeout",
            )
        ],
    )
    secondary = FakeProvider(
        name="secondary",
        model="model-b",
        outcomes=[make_response(provider="secondary", model="model-b")],
    )

    result = await make_router([primary, secondary]).generate(make_request())

    assert result.provider == "secondary"
    assert result.fallback_count == 1


@pytest.mark.asyncio
async def test_authentication_error_does_not_fallback() -> None:
    primary = FakeProvider(
        name="primary",
        model="model-a",
        outcomes=[
            AIProviderError(
                provider="primary",
                kind=ProviderErrorKind.AUTHENTICATION,
                message="invalid api key",
            )
        ],
    )
    secondary = FakeProvider(
        name="secondary",
        model="model-b",
        outcomes=[make_response(provider="secondary", model="model-b")],
    )

    with pytest.raises(AllProvidersFailedError):
        await make_router([primary, secondary]).generate(make_request())

    assert secondary.call_count == 0


@pytest.mark.asyncio
async def test_all_providers_fail() -> None:
    providers = [
        FakeProvider(
            name="primary",
            model="model-a",
            outcomes=[
                AIProviderError(
                    provider="primary",
                    kind=ProviderErrorKind.SERVER,
                    message="server error",
                )
            ],
        ),
        FakeProvider(
            name="secondary",
            model="model-b",
            outcomes=[
                AIProviderError(
                    provider="secondary",
                    kind=ProviderErrorKind.SERVER,
                    message="server error",
                )
            ],
        ),
    ]

    with pytest.raises(AllProvidersFailedError):
        await make_router(providers).generate(make_request())


@pytest.mark.asyncio
async def test_validation_failure_falls_back() -> None:
    primary = FakeProvider(
        name="primary",
        model="model-a",
        outcomes=[make_response(provider="primary", model="model-a", content="短い")],
    )
    secondary = FakeProvider(
        name="secondary",
        model="model-b",
        outcomes=[make_response(provider="secondary", model="model-b")],
    )

    result = await make_router([primary, secondary]).generate(make_request())

    assert result.provider == "secondary"
    assert result.validation_result is not None
    assert result.validation_result.is_valid is True


@pytest.mark.asyncio
async def test_total_timeout_is_enforced() -> None:
    class SlowProvider(FakeProvider):
        async def generate(self, request: AIRequest):  # type: ignore[override]
            await asyncio.sleep(0.2)
            return await super().generate(request)

    slow = SlowProvider(
        name="slow",
        model="model-slow",
        outcomes=[make_response(provider="slow", model="model-slow")],
    )

    with pytest.raises(AllProvidersFailedError):
        await make_router(
            [slow],
            provider_timeout_seconds=1.0,
            total_timeout_seconds=0.05,
        ).generate(make_request())
この最小例で実装していないもの
Streaming、tool calling、vision、audio、file API、embeddings、batch API、複数Provider同時送信、高度なCircuit Breaker、自動コスト最適化、React画面は対象外です。
発展段階では、Capability管理、Circuit Breaker、キャンセル伝播、Streaming途中エラー、再試行による重複課金も検討します。
ただし、最初からすべてを実装すると過剰設計になりやすいため、実運用で必要になった順に追加してください。
テストで確認するべきケース
- 第一候補Providerが成功する 第二候補を呼ばず、fallback_countが0になるか。
- 第一候補がタイムアウトし、第二候補が成功する 定義した条件でのみ次Providerへ進むか。
- 認証エラーでは無条件フォールバックしない 設定不備が別Providerで隠されないか。
- 全Providerが失敗する 無限ループせず、縮退運転や人間確認へ移れるか。
- API成功後に出力検証が失敗する 空文字・壊れたJSON・禁止HTMLを検出できるか。
- 総試行回数・総時間を超えない SDKとアプリの二重再試行で長時間待たされないか。
上の最小実装には、FakeProviderとInMemoryProviderLogRepositoryを使ったpytest例も含めています。
本番SDKを呼ばずに、切り替え条件・停止条件・総タイムアウトを確認してください。
Provider抽象化にもデメリットがある
実装量が増える
共通型、Adapter、Policy、Validator、テストの実装が必要です。
独自機能が使いにくくなる
すべてを共通化すると、各Providerの強みまで削る可能性があります。
品質は同じにならない
同じプロンプトでも、文章・JSON・安全制限の結果は変わります。
コストと遅延が増える
再試行やフォールバックが増えるほど、料金と待ち時間も増えます。
APIキー管理が増える
契約、請求、利用上限、Secret管理をProviderごとに確認します。
運用判断が必要になる
切り替え条件、停止条件、品質基準を決めなければなりません。
可用性が必ず上がるわけではない
複数Providerが同じネットワーク・認証・入力不備へ依存していれば、同時に失敗する可能性があります。
小さな検証では過剰設計になる
短期検証や個人だけが使う試作では、1ProviderとFakeProviderで十分な場合があります。
最初から作らなくてよい機能
後回しでよいもの
- 管理画面からの自由なProvider切り替え
- 自動で最安Providerを選ぶ機能
- 複雑なコスト最適化
- 全機能の完全共通化
- 多段階AIエージェント
- 自動復旧ダッシュボード
- 複数Providerへの同時送信
- 完全自動の品質判定
最初に作るもの
- 共通AIProvider
- 2〜3個のProvider Adapter
- 単純な優先順位
- 明示的なフォールバック条件
- 出力検証
- 最小限のログ
- 人間確認または縮退運転
まとめ:切り替えられることより、切り替えても安全に使えることが重要
- 共通リクエスト・レスポンスを定義する
- Provider固有処理をAdapterへ閉じ込める
- 再試行・切り替え・停止の条件を分ける
- すべてのエラーで無条件にフォールバックしない
- 切り替え後のJSON・HTML・必須項目を検証する
- Provider・遅延・失敗・採用結果をログに残す
- 全Provider停止時は縮退運転や人間確認へ移る
- 最初は2〜3Providerの小さな構成から始める
重要なのは、別Providerへ切り替えられることだけではありません。
切り替え後も業務要件を満たしているか確認し、使えない場合には安全に止める、または機能を限定して継続できることが、実務で使えるAIツール設計です。
実装前に確認したい公式情報
次に読む記事